
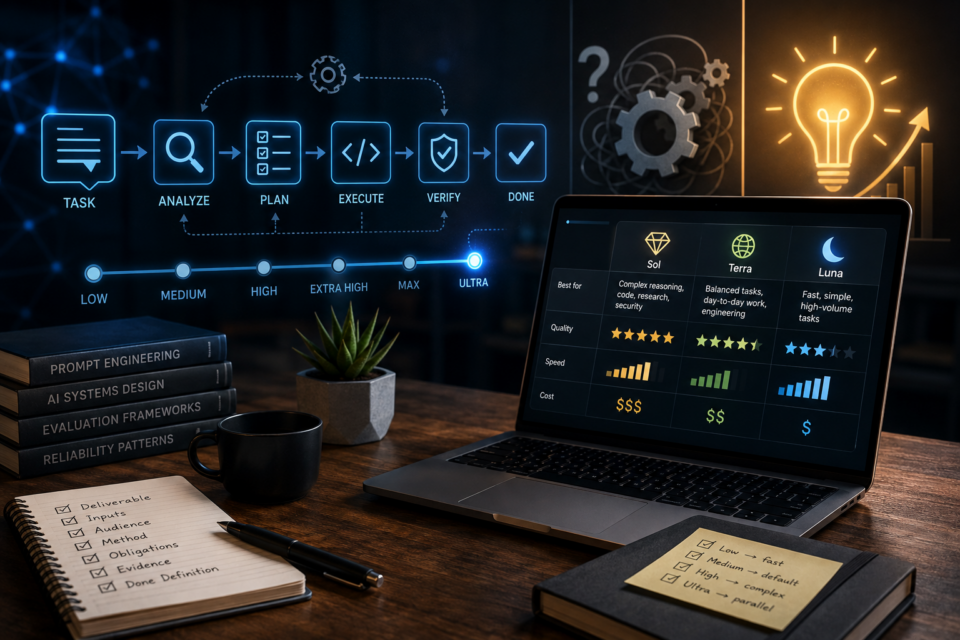
Самый дорогой способ работать с ИИ — держать флагман на максимальном рассуждении для всего подряд. Как выбрать модель и уровень рассуждений, чтобы не переплачивать: массовое переименование символов в репозитории и разбор перемежающегося сбоя распределённой системы — задачи разного класса, и платить за них одинаково незачем. В GPT-5.6 у вас три тира моделей и шесть уровней усилия, то есть восемнадцать с лишним комбинаций. Разберём, как выбирать между ними по признакам задачи, а не по привычке.
Три тира вместо зоопарка версий
OpenAI закрепила три уровня, которые теперь живут своим циклом обновлений: номер обозначает поколение, а Sol, Terra и Luna — устойчивые тиры возможностей. Sol — флагман для сложного кода, computer use, исследований и кибербезопасности. Terra — сбалансированная рабочая лошадка, по производительности конкурентная прошлому флагману GPT-5.5, но дешевле. Luna — самая быстрая и дешёвая в семействе.
Цифры помогают откалибровать интуицию. В API за миллион токенов Sol стоит 5 долларов на входе и 30 на выходе. С 30 июля 2026 года Terra подешевела на 20% — до 2 и 12 долларов, а Luna сразу на 80% — до 0,20 и 1,20 доллара. Важная деталь для тех, кто работает по подписке: в анонсе прямо сказано, что снижение отражается и на том, как расход считается против подписок в Codex и ChatGPT Work — Terra и Luna теперь съедают меньше кредитов.
Отсюда очевидный приём для агентных пайплайнов: Sol снимает неопределённость и пишет план, Luna реализует хорошо описанные изменения, запускает тесты и оценивает результат. Именно этот сценарий OpenAI приводит как пример разумного распределения — разная стоимость шага внутри одного рабочего процесса, а не одна модель на весь путь.
Шесть уровней рассуждений и два «тяжёлых» режима
Полная лестница выглядит так: Light (в CLI он называется Low), Medium, High, Extra High, Max и Ultra. Light подходит для быстрых узких задач, Medium — разумная точка старта для значимой работы, High и Extra High берут на себя многошаговые задачи с несколькими источниками и компромиссами.
Max и Ultra стоит понимать правильно, потому что их часто путают. Max просто даёт выбранной модели больше времени на размышление над одной задачей — если его нет в списке, он включается в настройках приложения. Ultra работает иначе: он поднимает субагентов и раскладывает части сложной задачи параллельно, по умолчанию координируя четыре агента. Смысл в нём появляется только тогда, когда работу реально можно разделить на самостоятельные куски. По доступности есть нюанс: в ChatGPT Work Ultra открыт Pro и Enterprise, а в Codex — тарифам от Plus и выше.
Дефолт в десктопном приложении — gpt-5.6-sol с медиум-рассуждением, и это честная отправная точка. Точного соответствия между уровнями GPT-5.5 и GPT-5.6 нет: в документации советуют прогнать привычную задачу на настройке ниже и скорректировать по результату.
Четыре оси, по которым нужно оценить задачу
Прежде чем крутить ползунки, оцените задачу по неоднозначности (путь очевиден или модель сама выбирает подход), последствиям (что будет, если ответ неверен), широте охвата (сколько файлов, систем и ограничений задействовано) и объёму (один ценный результат или тысячи однотипных элементов).
Дальше маршрутизация становится механической. Низкая неоднозначность, низкие последствия, узкий охват, большой объём — Luna на Low или Medium: классификация, извлечение полей из счетов, трансформации, структурированные сводки. Умеренная неоднозначность и последствия — Terra на Medium: обычная разработка, еженедельный статус-отчёт по структурированным заметкам, переименование символов по репозиторию с тестами. Высокая неоднозначность или последствия — Sol на Medium либо High: сравнение двух архитектурных предложений, анализ модели угроз. Критическое финальное решение или неразрешённый перемежающийся сбой — Sol на High или Extra High. А для генерации десятков тысяч офлайн-классификаций правильный ответ вообще не в интерфейсе: небольшая проверенная модель через API в батче.
Лестница эскалации: не прыгайте на верхнюю ступень
Порядок повышения такой. Сначала улучшить промпт и определение готового результата — это бесплатно и чаще всего достаточно. Потом попробовать Terra или дефолт. Потом поднять рассуждение с Low до Medium. Потом перейти на Sol. Потом до High или Extra High. И только в конце — Max или Ultra, если оставшийся разрыв в качестве это оправдывает.
Самая частая ошибка — поднимать уровень рассуждений из-за того, что промпт написан расплывчато. Модель начинает дольше и дороже угадывать вашу цель. Как превратить задание в контракт с явным определением готовности, разобрано в материале про промпт как контракт.
Соберите свой eval, даже если работаете один
Выбор модели должен быть решением на основе доказательств, а не престижа. Для повторяющейся задачи возьмите от пяти до двадцати репрезентативных примеров и оцените корректность, полноту, соответствие формату, качество цитирования, скорость, расход кредитов и — главное — сколько правок приходится вносить руками. Выбирайте самую дешёвую и быструю конфигурацию, которая стабильно проходит проверку.
Это ровно та дисциплина, которая отличает пилот от продакшена: тесты агента на мок-LLM позволяют прогонять такие наборы без оплаты каждого запуска, а слои продакшен-агента показывают, куда эту проверку встроить.
Две даты, которые стоит записать в календарь
31 августа 2026 года из Codex уходят gpt-5.4 и gpt-5.4-mini для тех, кто входит через аккаунт ChatGPT. Замену нужно внести заранее: gpt-5.4 на gpt-5.6-terra, gpt-5.4-mini на gpt-5.6-luna — в дефолтах воркспейса, сохранённых настройках моделей, управляемых конфигурациях, кастомных агентах и задачах по расписанию. Codex с собственным API-ключом и сам API это не затрагивает. Модели gpt-5.2 и gpt-5.3-codex в Codex со входом через ChatGPT уже устарели — проверьте скрипты и вызовы codex exec --model.
Второе изменение касается обычных диалогов. В августе OpenAI обновила Sol в Chat и заменила переключатель уровней слайдером «сколько думать» для Plus и Pro; там же Instant и режим рассуждения теперь работают на одной модели, так что тон ответа при повышении усилия не меняется. Free и Go получили дефолтом Luna, неограниченные текстовые чаты и кнопку Think для сложных вопросов. По внутренней оценке на финансовых, медицинских и юридических промптах ответы хотя бы с одной фактической ошибкой встречались примерно на 62% реже у Luna и на 68% реже у Sol, чем у GPT-5.5 Instant. Цифра внутренняя, но направление понятное: если вы ходили на старую модель ради «быстрых фактов», привычку стоит пересмотреть.